UTF-8のBOMあり・なしの違いとは?確認・削除方法と文字化け対策
初回掲載日:
最終更新日:
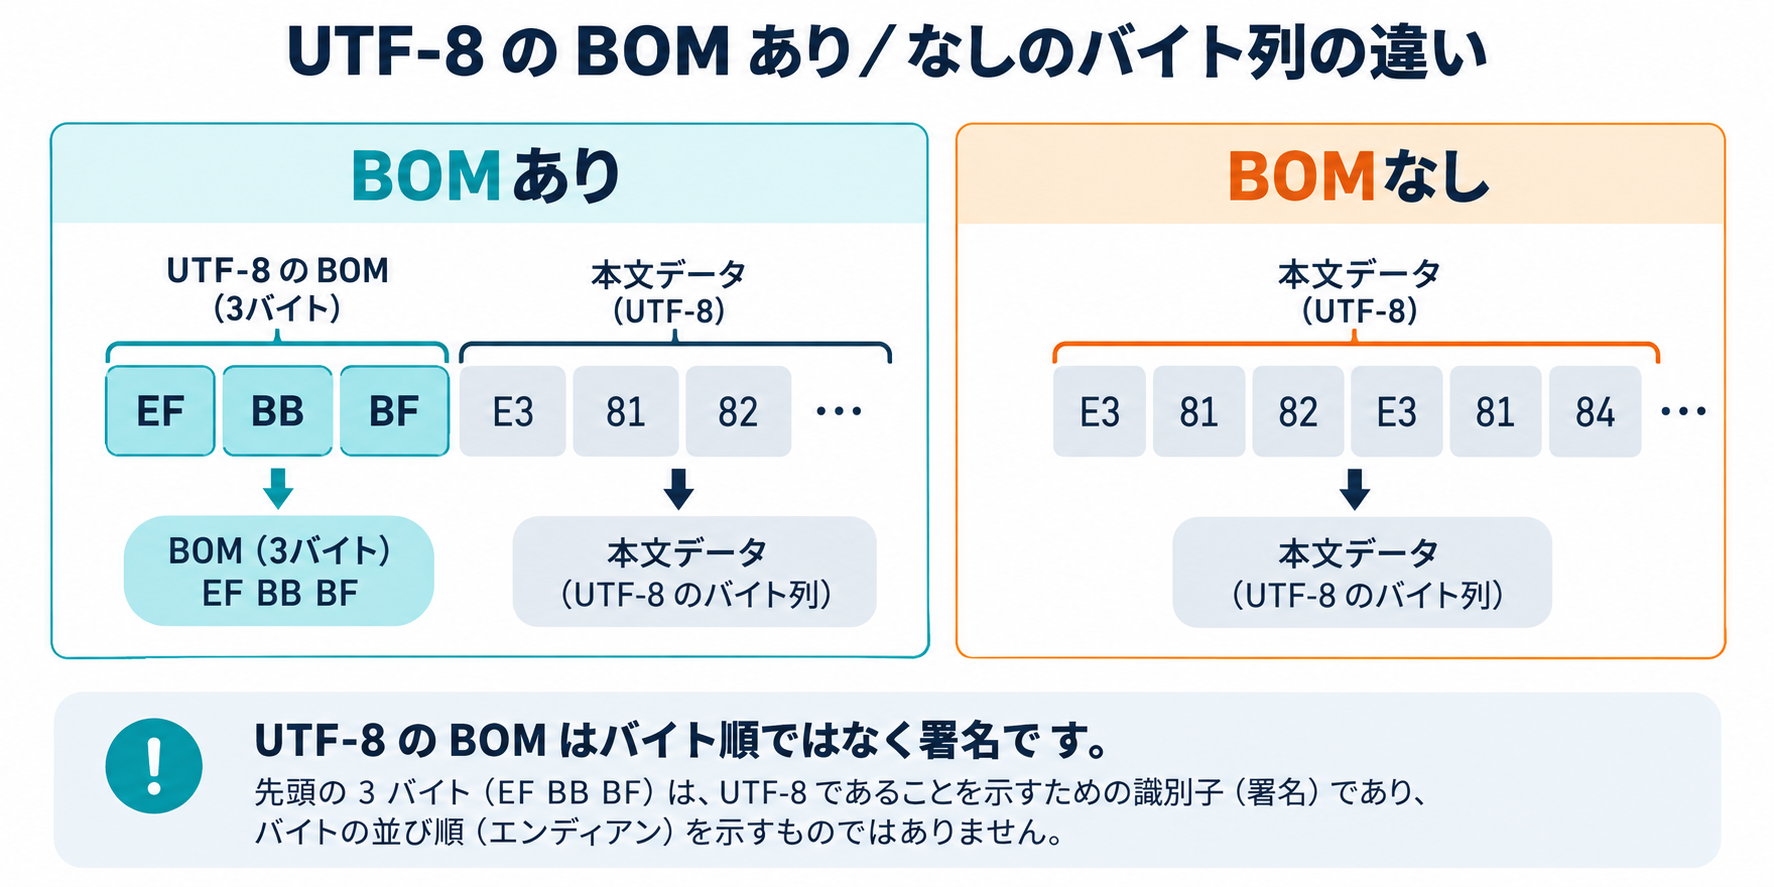
UTF-8のBOMあり・なしは、本文の文字コードが別物という意味ではありません。BOMありならファイル先頭に3バイトのEF BB BFが付き、BOMなしなら付きません。まず先頭バイトと受信側の仕様を確認し、必要な場合だけ変換するのが安全です。
- UTF-8のBOMは
EF BB BFという3バイトで、バイト順を示すものではなくUTF-8の署名として使われます。 - BOMなしだからUTF-8と断定できません。Shift_JISなど別の文字コードの可能性も確認します。
- Web、JSON、PHP、シェルスクリプトはBOMなしを基本にし、CSVやWindows固有の処理は受信側の要件に合わせます。
- 削除前に元ファイルを残し、先頭3バイトだけを確認して別名ファイルへ出力すると事故を減らせます。
UTF-8のBOMとは?
BOMはByte Order Mark(バイトオーダーマーク)の略です。Unicodeのデータストリーム先頭に置かれる識別子で、UTF-8ではEF BB BFの3バイトになります。
ただしUTF-8は8ビット単位の符号化方式なので、UTF-16やUTF-32のようなエンディアン判定は必要ありません。Unicode公式も、UTF-8でBOMを使う場合はバイト順ではなく、別のエンコーディングと区別するための署名だと説明しています。
BOMあり・なしの違い
| 項目 | BOMあり | BOMなし |
|---|---|---|
| 先頭バイト | EF BB BFの3バイト | 本文の先頭バイトから開始 |
| UTF-8としての有効性 | UTF-8として扱える | UTF-8として扱えるが、BOMなしだけでは判定できない |
| 役割 | UTF-8である可能性を示す署名 | 余分な署名を付けない形式 |
| 互換性 | 対応ソフトでは便利だが、一部ツールで先頭文字扱いになる | Unix系ツールや多くのWeb用途で扱いやすい |
| サイズ | 本文に3バイト加算 | 加算なし |
BOMの有無だけで優劣は決まりません。読み手がBOMを認識するか、先頭3バイトをデータとして扱わないか、既存の連携仕様が何を要求するかで選びます。
先頭バイトを16進数で確認する
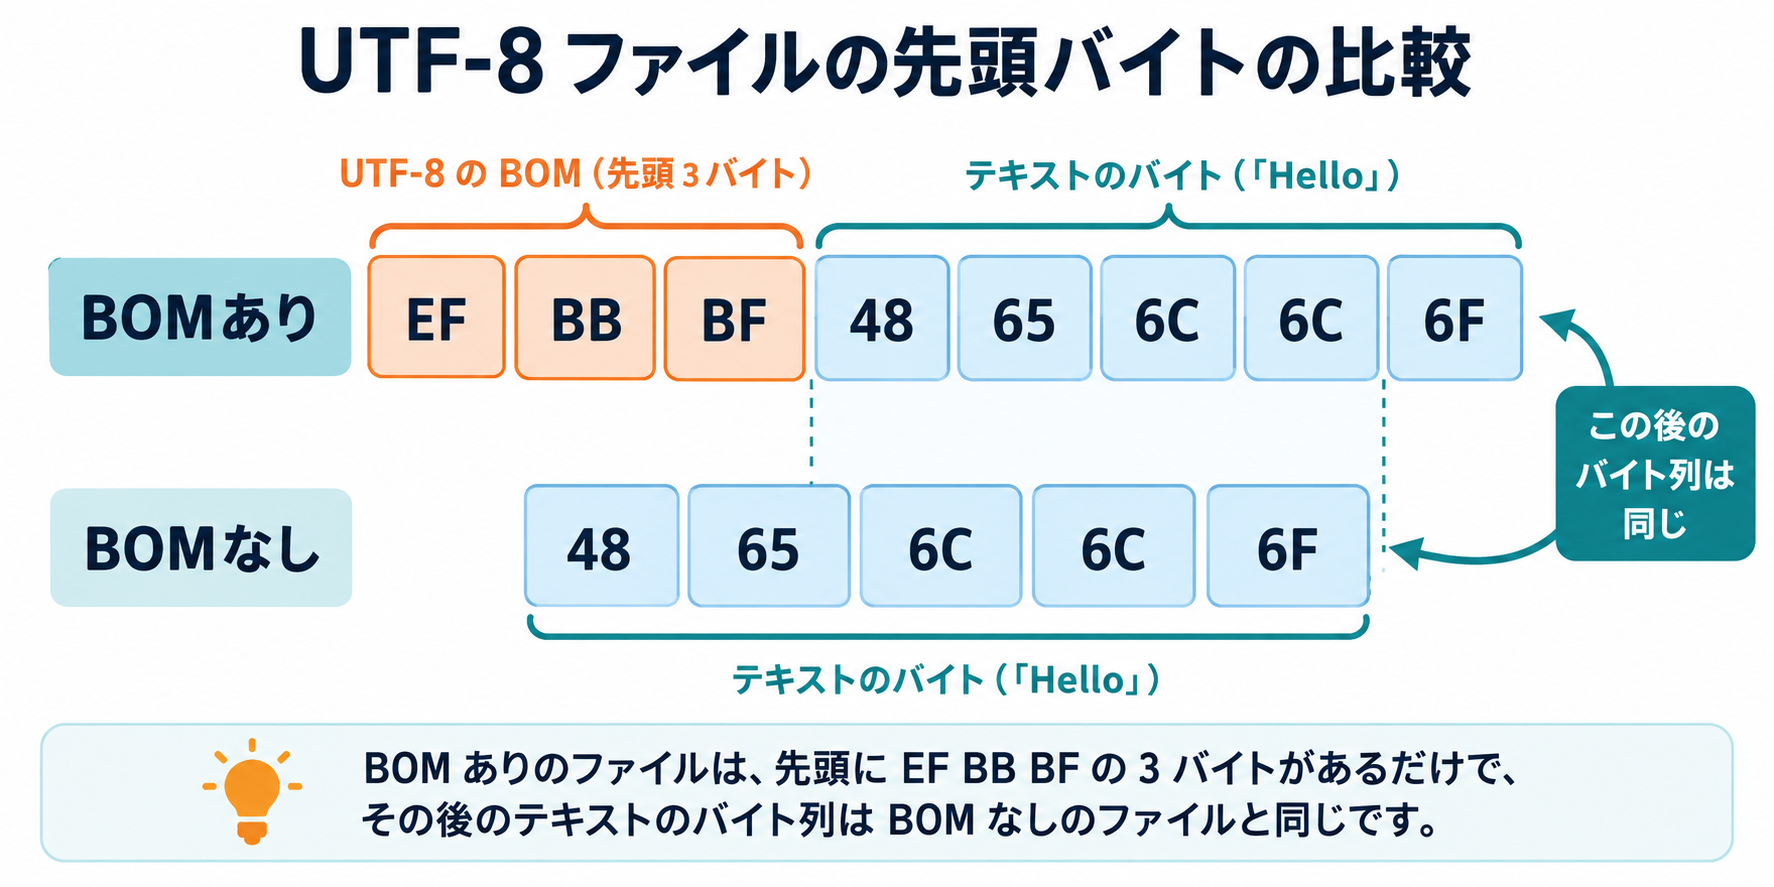
エディターの表示だけでなく、ファイルをバイナリとして読み、先頭3バイトを確認します。BOMありならEF BB BFが先頭に並びます。BOMがない場合でも、UTF-8だと確定するには内容や送受信仕様の確認が必要です。
PowerShellで確認する
次の例は、ファイル全体を文字列として再保存せず、先頭バイトだけを読む方法です。空ファイルも考慮しているため、実際の確認対象へパスを置き換えて使います。
$path = ".\sample.txt"
$bytes = [System.IO.File]::ReadAllBytes($path)
$count = [Math]::Min(3, $bytes.Length)
if ($count -gt 0) {
    ($bytes[0..($count - 1)] | ForEach-Object { "{0:X2}" -f $_ }) -join " "
}
$hasBom = $bytes.Length -ge 3 -and
    $bytes[0] -eq 0xEF -and $bytes[1] -eq 0xBB -and $bytes[2] -eq 0xBF
"BOMあり: $hasBom"
Pythonで確認する
Pythonではread_bytes()を使うと、デコード前のバイト列をそのまま検査できます。
from pathlib import Path

data = Path("sample.txt").read_bytes()
has_bom = data.startswith(b"\xef\xbb\xbf")
print("BOMあり" if has_bom else "BOMなし")
print(data[:3].hex(" "))
PowerShellのバージョンで保存結果が変わる
PowerShellはバージョンによって既定のエンコーディングと指定できる名前が異なります。特にWindows PowerShell 5.1とPowerShell 6以降を同じものとして扱わないでください。
| 環境 | UTF-8の指定例 | 注意点 |
|---|---|---|
| Windows PowerShell 5.1 | -Encoding UTF8 | UTF-8 BOM付き。既定動作もコマンドごとに不統一 |
| PowerShell 7以降 | -Encoding utf8NoBOM / utf8BOM | 既定はUTF-8 BOMなし。BOMの有無を明示できる |
例えばPowerShell 7以降でBOMなしへ保存する場合は次のように書けます。既存ファイルを上書きする前に、別名出力やバックアップを選びます。
$text = Get-Content -LiteralPath ".\sample.txt" -Raw
Set-Content -LiteralPath ".\sample-no-bom.txt" -Value $text -Encoding utf8NoBOM
Windows PowerShell 5.1で同じ結果を確実に得たい場合は、使用する.NET APIと保存先を固定し、実際の先頭バイトを確認します。コマンド名だけを見てBOMの有無を推測しないことが重要です。
Pythonのutf-8-sigで読み書きする
Pythonのutf-8-sigは、書き込み時にUTF-8 BOMを付け、読み込み時にはファイル先頭にBOMがあればスキップするcodecです。BOMを扱う必要がある連携先で便利ですが、ファイル途中に現れるU+FEFFまで無条件に削除する処理ではありません。
from pathlib import Path

src = Path("sample.txt")
text = src.read_text(encoding="utf-8-sig")

# BOMなしで別ファイルへ保存
Path("sample-no-bom.txt").write_text(text, encoding="utf-8")

# BOMありで別ファイルへ保存
Path("sample-with-bom.txt").write_text(text, encoding="utf-8-sig")元ファイルを直接変更せず、sample-no-bom.txtのような別ファイルを作って、読み手側で検証してから置き換えます。
用途別にBOMあり・なしを判断する
| 用途 | まず選ぶ方向 | 判断のポイント |
|---|---|---|
| HTML | BOMなしが扱いやすい | 配信サーバーやツールの仕様を優先する |
| JSON | BOMなしを基本にする | 送信先・パーサーが先頭BOMを許容するか確認する |
| PHP | BOMなし | PHP開始タグより前のBOMが出力になり、ヘッダー処理へ影響する場合がある |
| シェルスクリプト | BOMなし | shebangがファイル先頭から始まらず、実行時に問題になることがある |
| CSV | 受信側仕様を確認 | Excel等との互換性を優先してBOMを求められるケースがある |
| PowerShellスクリプト | 対象環境次第 | Windows PowerShellで非ASCII文字を含む場合とUnix系ツールの両方を確認する |
| Pythonデータ処理 | 受信側次第 | utf-8-sigで先頭BOMを吸収する方法もある |
CSVに必ずBOMを付ける、または絶対に付けないという一律のルールは危険です。Excelのバージョン、インポート方法、受け渡し相手の仕様を確認してください。
安全にBOMを削除する方法
- 元ファイルをコピーし、バックアップを残す。
- バイナリで先頭3バイトが
EF BB BFか確認する。 - 先頭3バイトだけを除去し、別名ファイルへ保存する。
- 文字化け、改行、行数、JSONやCSVの構文を確認する。
- 受信側で読み込みテストをしてから本番ファイルを置き換える。
先頭のBOMだけを除去するのがポイントです。ファイル全体の文字列から\uFEFFを一括置換すると、本文中で意味を持つゼロ幅ノーブレークスペースまで壊す可能性があります。
BOMと文字化けは同じ問題ではない
BOMが原因で先頭列名に余計な文字が入り、処理が失敗することはあります。しかし、文字化けの原因は文字コードの不一致、誤ったデコード、再エンコード、改行コード、ファイル形式の取り違えなどにもあります。
例えばShift_JISのファイルをUTF-8として読めば、BOMがなくても文字化けします。BOMを削除する前に、送信側のエンコーディング、受信側の指定、改行コード、実際のバイト列を順番に切り分けます。
CSV・JSON・PHPで起きやすい注意点
CSV
CSVの先頭列名が\uFEFFnameのように見える場合は、読み込み側がBOMを列名の一部として扱っていないか確認します。一方、受信側がBOMを目印として利用する場合もあるため、削除前に相手の取り込み仕様を確認します。
JSON
JSONは仕様と個々のパーサーの挙動を分けて考えます。送信データへBOMを付ける前に、利用するライブラリが先頭BOMを処理できるかテストしてください。
PHP
PHPファイルの開始タグより前にBOMがあると、意図しない出力として扱われ、HTTPヘッダー送信やCookie設定に影響する場合があります。ただし、すべてのPHPエラーをBOMのせいにせず、実際の先頭バイトとエラー発生箇所を確認します。
文字化け・読み込み失敗の診断フロー
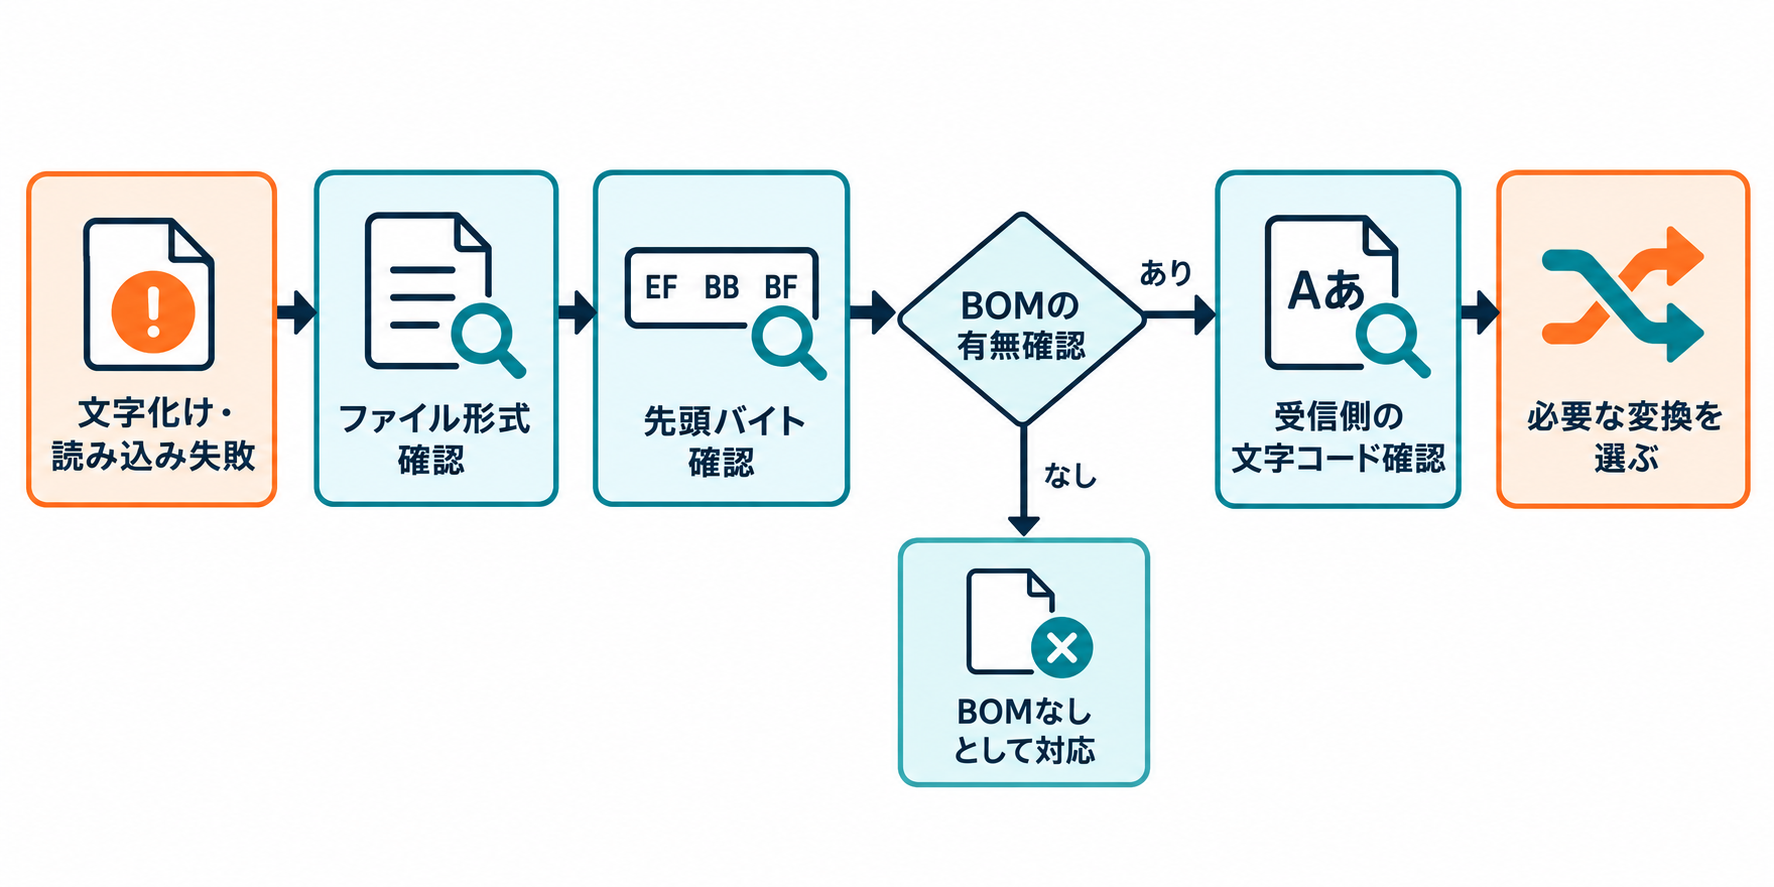
- 失敗しているファイル形式と読み込み処理を特定する。
- 送信側が何の文字コードで保存したかを確認する。
- 先頭3バイトを16進数で確認する。
- BOMがデータとして扱われているのか、そもそも文字コードが違うのかを分ける。
- 受信側のBOM対応と文字コード指定を確認する。
- 別名ファイルで変換し、元データと行数・構文・日本語を比較する。
よくある質問
UTF-8はBOMありが正しいですか?
どちらもUTF-8として存在します。UTF-8ではBOMは必須ではなく、利用するツールや連携仕様で決めます。
BOMなしならUTF-8と判定できますか?
できません。BOMがないことは「先頭に署名がない」ことを示すだけです。Shift_JISなどの可能性も含めて、保存側と内容を確認します。
EF BB BFを本文から全部削除すればよいですか?
いいえ。ファイル先頭の3バイトだけを対象にします。本文中のU+FEFFを無条件に削除する処理は避けてください。
Excel用CSVにはBOMを付けるべきですか?
受け手のExcelのバージョンや取り込み方法によります。実際の受け渡し環境でBOMあり・なしを試し、列名と日本語が正しく読める方を採用します。
確認チェックリスト
- 対象ファイルの形式と受信側を特定した
- 先頭バイトを確認し、EF BB BFの有無を記録した
- BOMの有無と文字コードの判定を混同していない
- 元ファイルを残して別名で変換した
- 文字化け、改行、CSV列名、JSON構文を確認した
- PHPやシェルスクリプトでは先頭バイトが0位置から始まることを確認した
- PowerShellのバージョンを明記した
- 受信側の仕様に合わせてBOMを選んだ
まとめ
UTF-8のBOMあり・なしの差は、ファイル先頭にEF BB BFの3バイトがあるかどうかです。UTF-8のバイト順を決めるものではなく、署名として扱われます。
迷ったときは、先頭バイトを確認し、受信側の仕様を特定し、別名ファイルで変換して検証します。Web・JSON・PHP・シェルではBOMなしを基本にしつつ、CSVやWindows固有の連携では互換性を優先するのが現実的です。