GPT-6のPrompt Cachingとは?最大90%割引・30分キャッシュ・Dashboard・設定方法を整理
初回掲載日:
最終更新日:
結論:GPT-6のPrompt Cachingは、複数のAPIリクエストで繰り返す共通のprompt prefixを再利用し、入力処理の待ち時間とコストを抑える仕組みです。
- 割引:最大90%割引の対象は、再利用されたcached input tokensです。出力トークンを含むAPI料金全体が90%安くなる意味ではありません。
- 保持:GPT-6を含む新しいモデルでは、
prompt_cache_options.ttlの既定値・指定値として30mが案内されています。直近の書き込みまたは再利用から少なくとも30分が目安で、すべてのキャッシュが必ず30分で消えるという意味ではありません。 - 確認:Prompt Caching Dashboardでhit rateを見て、Diagnosticsでmissの理由を調べられます。
- 設定:基本は対応モデルで自動有効。安定したprefixを明示したい場合は、explicit breakpointやprewarmingを使います。
GPT-6のPrompt Cachingとは?
Prompt Cachingは、同じpromptの先頭部分を毎回ゼロから処理せず、以前計算した状態を再利用する仕組みです。長時間動くAIエージェントでは、共通のinstructions、tool definitions、参照資料、会話履歴を複数のリクエストで繰り返し送るため、再利用できる部分が大きくなります。
OpenAIの開発者ドキュメントでは、キャッシュされるのは単なる文字列ではなく、再利用可能なprefixに対応するモデルのKV(key-value)状態と説明されています。後続リクエストは新しい入力を処理しながら、先頭の一致した部分を使い回します。
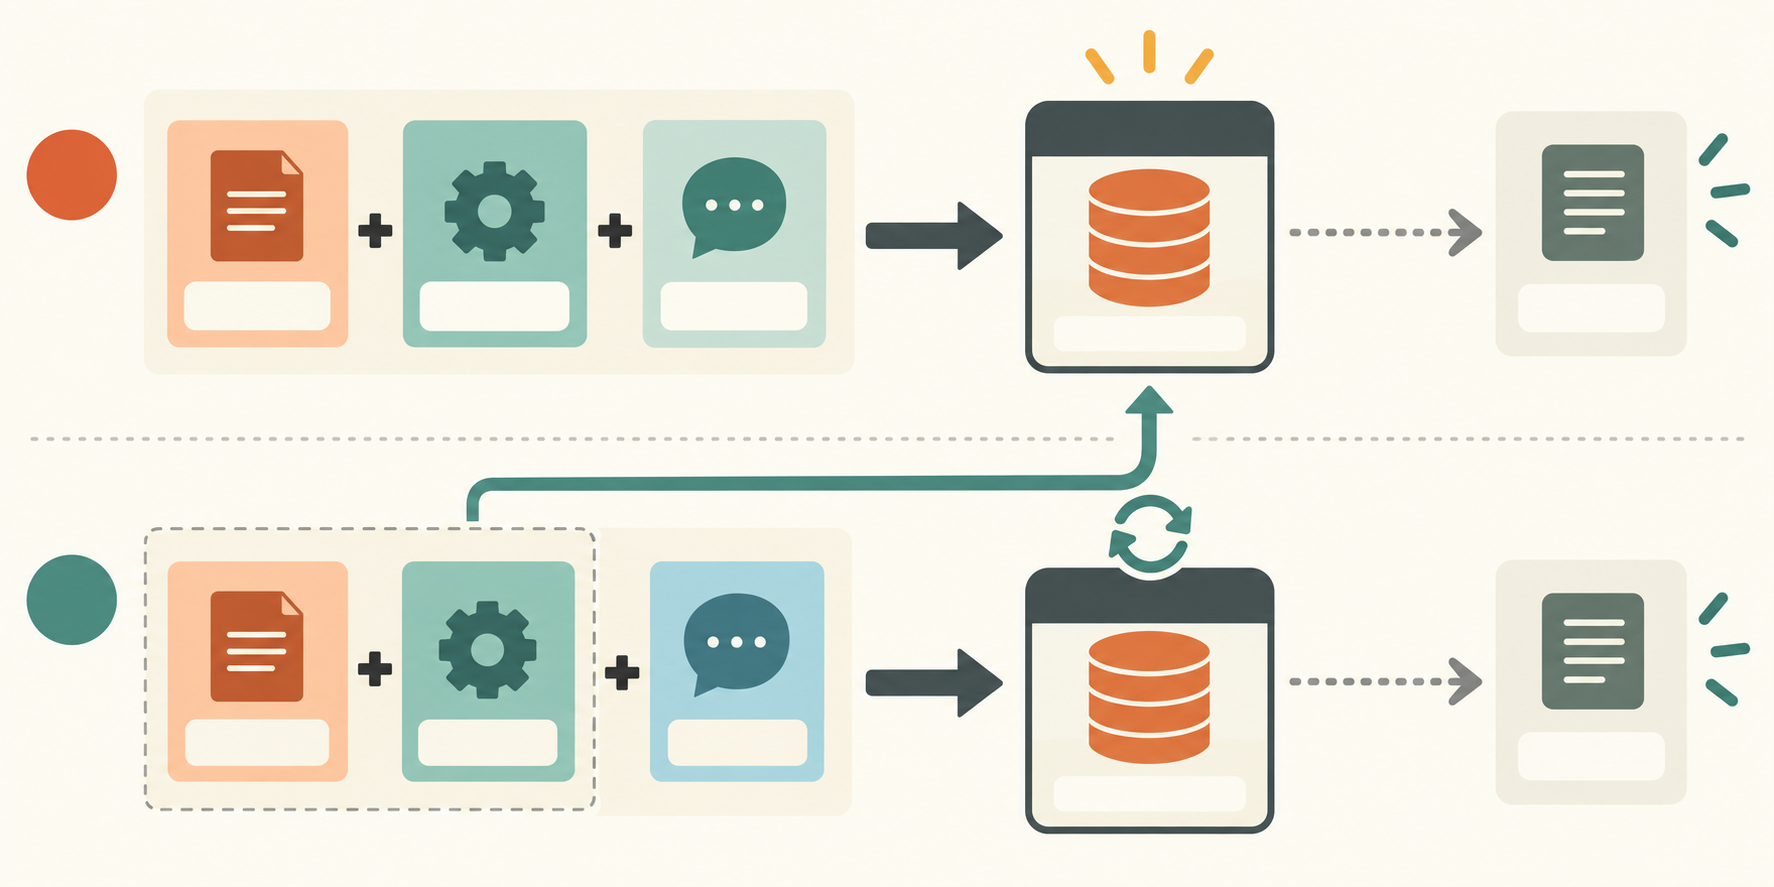
通常のinputとcached inputの違い
| 項目 | 通常のinput | cached input |
|---|---|---|
| 処理 | 共通prefixも新しく処理 | 一致したprefixの計算状態を再利用 |
| 入力料金 | 通常のinput token料金 | モデルごとのcached input料金 |
| 出力 | 新しい回答を生成。Prompt Cachingは出力生成をキャッシュする機能ではない | |
| 向くケース | 短い単発request、毎回prefixが変わる処理 | 長いinstructions、tool、参照資料を繰り返す処理 |
最大90%割引と「30分」の正しい意味
90%安くなるのはcached input tokens
OpenAI公式の「最大90%割引」は、再利用条件を満たしたcached input tokensに対する説明です。output tokenや、まだキャッシュされていないinput tokenまで含めた請求額全体が90%減るわけではありません。
公開時点のOpenAI API Pricingでは、Standard・短いコンテキストの例として、GPT-6 Astraはinput 1M tokensあたり10ドル、cached input 1ドル、GPT-6 Solは2ドルと0.20ドル、GPT-6 Lunaは0.10ドルと0.01ドルです。実際の料金はモデル、コンテキスト長、処理モードなどで変わるため、利用前に公式Pricingを確認してください。
30分はキャッシュの絶対的な消去時刻ではない
新しいモデル向けドキュメントでは、prompt_cache_options.ttlのサポート値として30mが案内され、キャッシュprefixは直近のwriteまたはreuseから少なくとも30分、再利用対象として有効です。OpenAIがそれより長く保持する可能性もあります。したがって、「30分経過した瞬間に必ず消える」と理解するのは正確ではありません。
保持設定や既定値はモデル世代や組織のデータ保持設定によって異なります。GPT-6向けの新仕様を、古いモデルのprompt_cache_retentionと混同しないようにしてください。
Dashboardでhit rate、Diagnosticsでmiss原因を確認
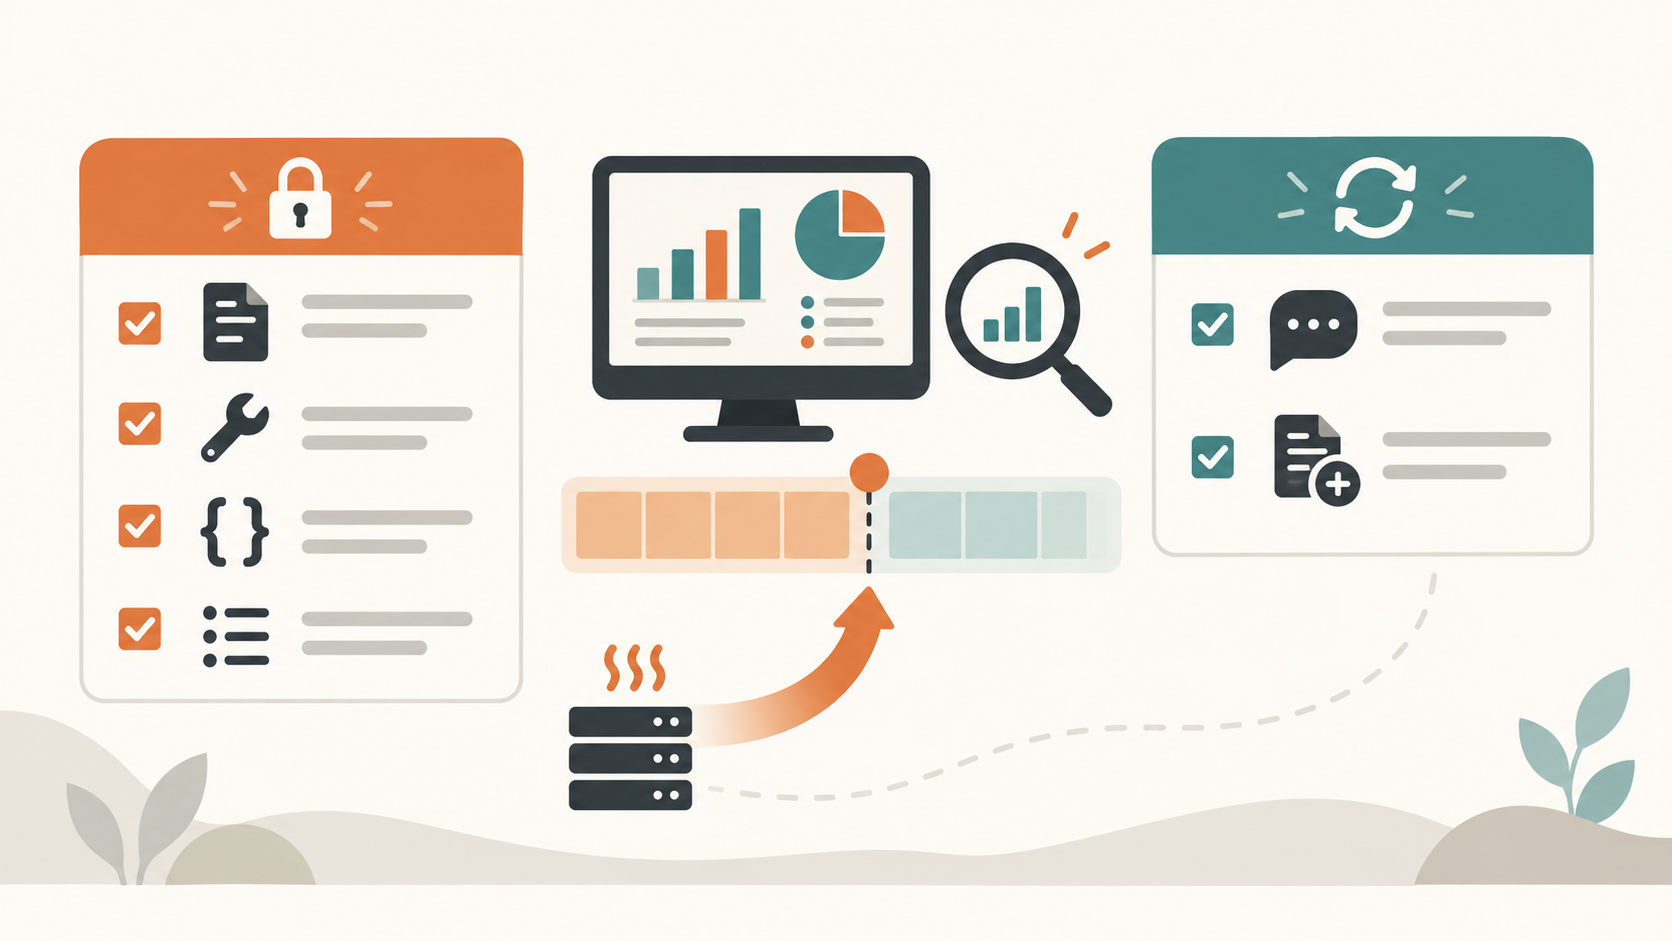
Prompt Caching Dashboardは、アプリの入力のどの程度がキャッシュから提供されたかを確認する管理画面です。hit rateの推移や、cached tokensとuncached tokensの構成を見れば、設定変更後に再利用が増えたかを比較できます。
予想よりcache hitが少ないときは、Prompt Cache Diagnosticsで現在のリクエストと最近のresponseを比較します。公式例では、tool定義が変わった場合の理由としてtools_changedが返ります。ほかにも、model、service tier、出力形式、reasoning effort、verbosity、context compaction、入力変更などがmissの原因として分類されます。
Diagnosticsはcache hitを保証する機能ではありません。原因候補を一つずつ確認し、修正後にcached_tokens、cache_write_tokens、latency、総コストを複数回の代表リクエストで比較するための機能です。
Prompt Cachingの設定・最適化方法
1. まずは自動キャッシュを使う
対応するOpenAIモデルではPrompt Cachingがデフォルトで有効です。最初から特殊なフラグを追加するより、まず共通prefixを安定させ、レスポンスのusageやDashboardでcached inputを確認します。ただし、同じsessionを維持しただけでcache hitが保証されるわけではありません。
2. 安定した内容をpromptの前方へ置く
毎回変わらないdeveloper instructions、tool definitions、schema、参照資料は前方に置きます。時刻、request ID、ユーザー固有の値、今回だけの指示などは後方へ移し、過去の会話やtool結果は可能なら書き換えずappendします。prefixの途中を変更・並べ替え・削除すると、それ以降の一致が崩れる可能性があります。
3. explicit cache breakpointで境界を決める
明示的に再利用範囲を決めたい場合は、prompt_cache_options.modeをexplicitにし、対応するcontent blockにprompt_cache_breakpoint: { "mode": "explicit" }を付けます。安定したdeveloper instructionsの末尾にbreakpointを置き、頻繁に変わるユーザー入力はその後ろに置く、という考え方です。
{
  "prompt_cache_options": {
    "mode": "explicit",
    "ttl": "30m"
  },
  "input": [{
    "role": "developer",
    "content": [{
      "type": "input_text",
      "text": "再利用する共通instructions...",
      "prompt_cache_breakpoint": { "mode": "explicit" }
    }]
  }]
}
これは概念を示す最小例です。対象モデル、Responses APIの入力形式、content blockの位置は、実装時に最新のPrompt Caching guideで確認してください。explicit-only modeではbreakpointを置かなかったrequestはcache writeを作らない仕様もあるため、設定を変えた後はusageを確認します。
4. toolの定義を変えず、使えるtoolだけを切り替える
toolを毎回追加・削除・並べ替えたり、schemaや説明文を変えたりするとprefixの一致が崩れます。定義・順序・schemaを安定させたまま、使わない回はtool_choice: "none"、一部だけ許可する場合はallowed_toolsを使う方法が公式に案内されています。
5. reasoning effortを変えるときはconfiguration update
GPT-6など対応モデルでは、request-levelのreasoning.effortを毎回書き換える代わりに、既存の入力へconfiguration_updateをappendして後続responseのeffortを変更できます。元のrequest-level設定を維持することで、先にあるprefixの再利用を保ちやすくします。
{
  "type": "configuration_update",
  "reasoning": { "effort": "high" }
}
対応範囲や互換性には条件があるため、すべてのrequestで無条件にcacheが維持されるという意味ではありません。
6. prewarmingで最初の待ち時間を前倒しする
起動時に共通instructions、tool definitions、参照資料などをあらかじめ準備しておくのがprewarmingです。Responses API requestでprompt_cache_options.prewarmをtrueにすると、出力を生成せずにcacheを準備できます。その後、同じprefixで実際のrequestを送ります。
prewarm自体にもcache writeの料金が発生するため、ユーザーが実際に再利用する見込みがあるcontextで使うのが基本です。
Prompt Cachingの効果が大きいケース・小さいケース
- 効果が大きい可能性:長時間AIエージェント、長いsystem/developer instructions、大量のtool definitions、共通reference material、複数turnで同じcontextを引き継ぐ処理。
- 効果が小さい可能性:短い単発request、毎回promptの先頭が変わる処理、同じprefixを再利用する前に利用が終わる処理。
cache hit率だけを目標にすると、不要な長文を増やしたり、変化する情報までcache writeしたりすることがあります。Dashboardでhit率とコストを一緒に見て、実際のワークロードで判断してください。
ChatGPTのMemoryやCodexの利用枠とは別
今回のPrompt Cachingは、OpenAI APIが入力の共通prefixを再利用する開発者向けの仕組みです。ChatGPTアプリの会話履歴やMemoryが「30分だけ残る」機能ではありません。
Codexについては、OpenAI公式発表がcache改善のコードレビューや測定にCodexを使う例を紹介しています。ただし、APIのPrompt CachingとCodexのユーザー向け利用枠・料金は別の話です。Codexを使えば利用料金が自動的に90%下がる、とは考えないでください。
FAQ
Q. GPT-6 Prompt Cachingとは?
A. 複数のAPI requestで繰り返すprompt prefixの計算状態を再利用し、入力処理を速くし、再利用されたcached input tokensの料金を下げる仕組みです。
Q. API料金全体が90%安くなりますか?
A. いいえ。最大90%割引はcached input tokensが対象です。uncached input、cache write、outputの料金は別に計算されます。
Q. 設定しなくても使えますか?
A. 対応モデルでは自動キャッシュがデフォルトです。再利用範囲を細かく決めたいときだけ、explicit breakpointやprewarmingを検討します。
Q. キャッシュは30分で消えますか?
A. 30分はGPT-6を含む新しいモデル向けのcache eligibilityの目安です。直近のwriteまたはreuseから少なくとも30分が案内され、OpenAIが長く保持する可能性もあります。
Q. cache missの理由は調べられますか?
A. Prompt Cache Diagnosticsで、比較対象のresponseと現在のrequestの差分を調べられます。tools_changed、model_changed、input_changedなどの理由が返る場合があります。
Q. reasoning effortを変えるとcacheは消えますか?
A. request-levelの設定を直接変えるとprefixに影響する可能性があります。対応モデルではconfiguration_updateをappendする方法が公式に案内されていますが、互換性条件は最新ドキュメントで確認してください。
Q. ChatGPTの会話履歴と同じですか?
A. 別物です。Prompt CachingはOpenAI APIの入力処理と料金に関する仕組みです。
まとめ
GPT-6のPrompt Cachingは、長時間動くAIエージェントや、同じinstructions・tools・contextを繰り返すAPI処理で効果を検討しやすい機能です。最大90%割引はcached input tokensに対するもの、30分は再利用資格の目安であり、全料金や全cacheの消去時刻を意味しません。
まずは自動キャッシュを使い、共通prefixを安定させます。そのうえでDashboardでhit rateと入力構成を確認し、missがあればDiagnosticsで原因を調べ、必要な箇所だけexplicit breakpointやprewarmingを導入するのが現実的です。