GPT-Live-1 APIとは?話しながら聞ける音声AIの料金・新機能を整理
初回掲載日:2026/09/12
最終更新日:
GPT-Live-1は、話しかける人との会話を続けながら、必要に応じてバックエンドのモデルやAgentへ作業を委譲できる音声AIのためのAPIです。OpenAI公式ドキュメントでは、話しながら聞くfull-duplexな会話と、裏側のAgent作業を両立する構成が案内されています。
先に結論
GPT-Live-1は「音声で会話を担当する層」、調査・検索・業務処理などは「バックエンドAgent」が担当する、と分けると理解しやすい仕組みです。音声Sessionは秒単位で課金され、公式Pricingでは$0.05/分。バックエンドのモデルやToolの料金は別にかかります。
| 項目 | 要点 |
|---|---|
| 会話 | 聞きながら話すfull-duplexの会話構成 |
| 深い処理 | 必要に応じてbackend model / Agentへ委譲 |
| 接続 | ブラウザ向けWebRTC、サーバー向けWebSocket、電話向けSIPが案内されています |
| 料金 | GPT-Live-1は$0.05/分。秒単位で計算、backend・Toolは別料金 |
GPT-Live-1 APIとは? 会話を続けながら仕事を進める音声AI
通常の音声機能は、ユーザーが話す、音声を文字にする、AIが答えを作る、音声で返す、という順番を意識しがちです。GPT-Liveの公式ガイドは、会話を担当するGPT-Liveが、バックエンドAgentの作業中も利用者との会話を続ける構成を示しています。
たとえば「近くの営業時間を調べて」と話しかけたとき、会話側は「確認しますね」と応答し、裏側では別のモデルやAgentが検索・Tool利用・結果の整理を進める、という分担です。すべての判断を音声側だけに任せるのではなく、会話と重い処理を役割で分けられるのがポイントです。
従来の「話す→待つ」と何が違う?
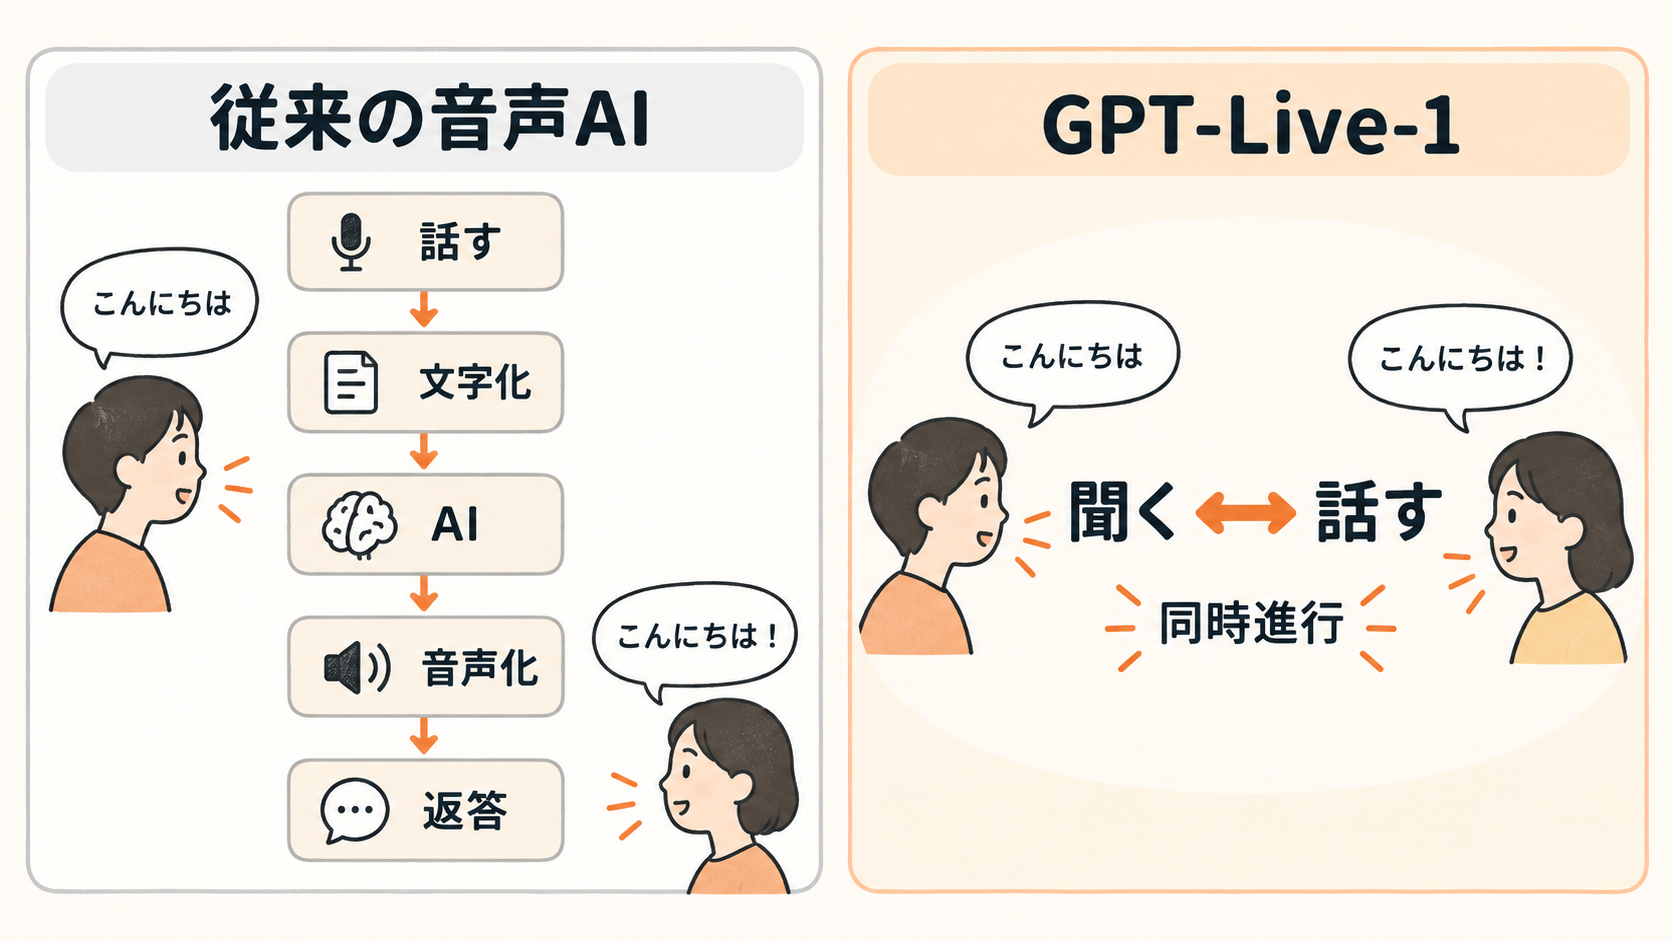
full-duplexは、相手が話している最中でも聞き続け、会話の流れを保ちやすくする考え方です。OpenAIは、GPT-Liveが話しながら聞けること、バックエンド作業をしている間も会話を継続できることを案内しています。
ただし、自然に感じるかはマイク、通信、周囲の雑音、発話の長さ、アプリ側の会話設計にも左右されます。雑音や無音を万能に処理するものと考えず、実機・実環境での検証が必要です。
GPT-Live-1は会話担当。調査や実行はバックエンドへ委譲できる
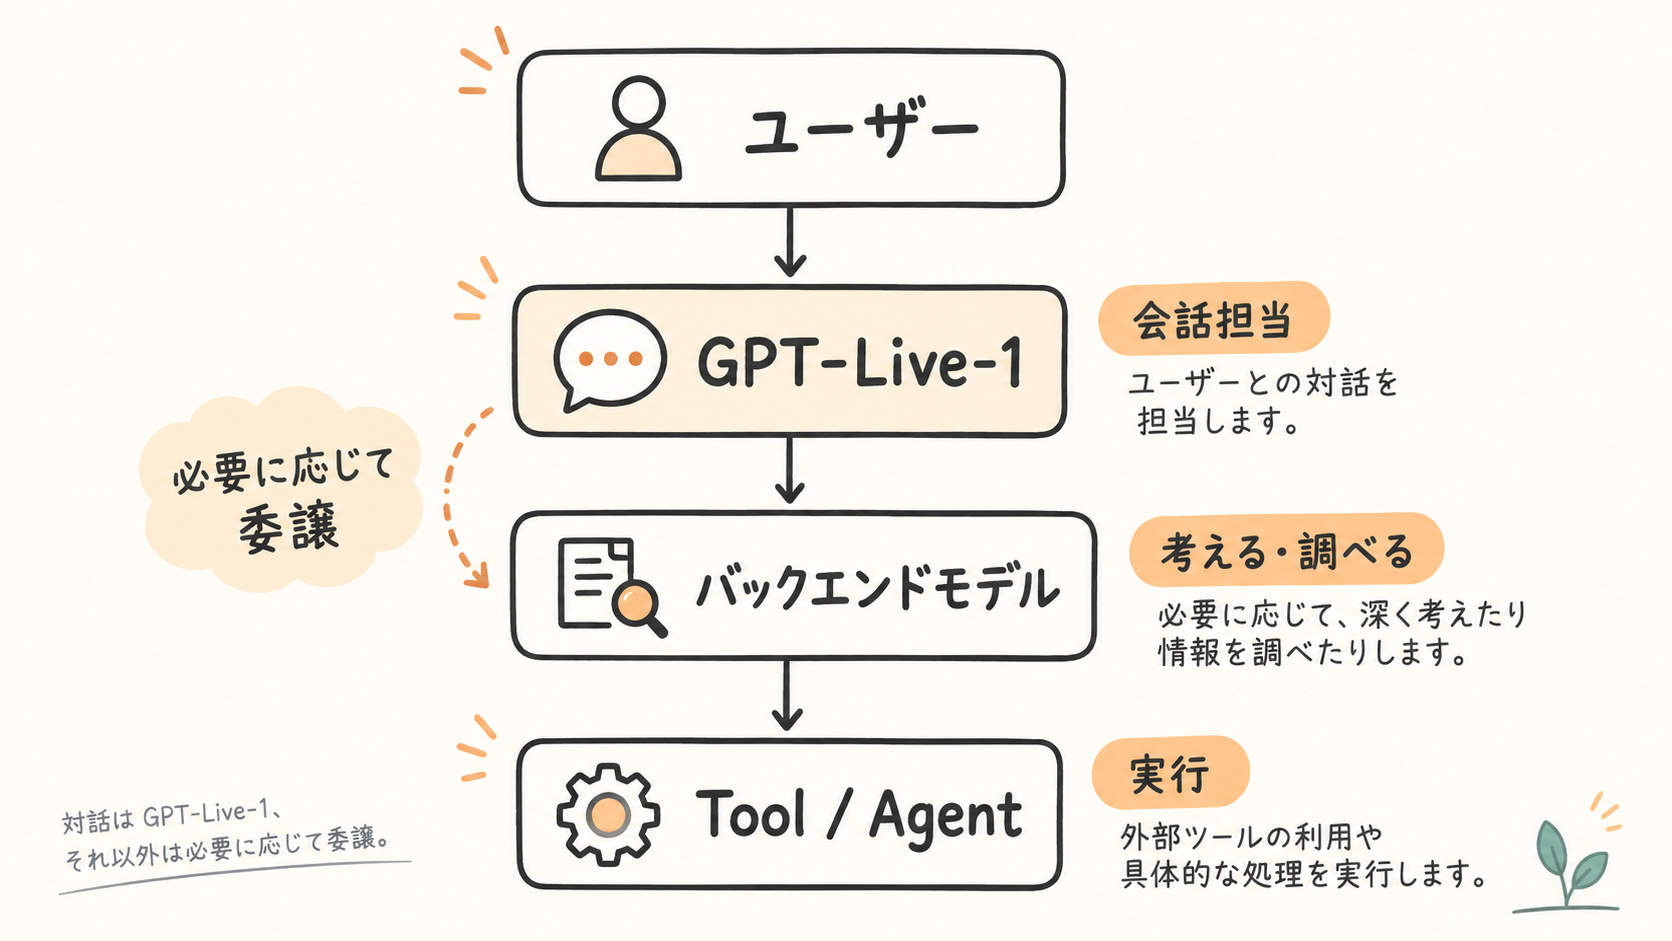
公式ガイドでは、GPT-Liveは会話を聞き、話し、どの処理を委譲するかを判断し、backendはより詳しい業務・Tool・workflowを扱う役割として説明されています。Responses対応モデルへ委譲する構成だけでなく、client delegationで任意のモデル、Agent harness、サービスへつなぐ方法も案内されています。
ここでCodexとの接点を考えるなら、GPT-Live-1がCodexを内蔵するという意味ではありません。コード調査や修正のような長い作業を別のAgent側で担い、音声側は利用者に進行を伝える、といった役割分担として設計を検討できます。
割り込み・文字起こし・確認フローで気を付けたいこと
話しかけて割り込んでも、裏側の仕事は自動では止まらない
OpenAIのガイドは、利用者が音声を割り込ませても、バックエンドの仕事は自動的にはキャンセルされないと明記しています。たとえば予約処理や送信のような副作用があるToolでは、キャンセル方法、再確認、完了通知をアプリ側で設計する必要があります。
文字起こしはUIやログに使えるが、確定文ではない
入力・出力のtranscriptはdeltaイベントで取得でき、開始・終了時刻も扱えます。一方で、断片的な内容は未完成だったり誤りを含んだりする可能性があります。画面表示やアプリ状態の管理では、最終状態を自分で持つ設計が安全です。
音声の区切り検出、確認の出し方、割り込み後の状態は、アプリごとに試験すべき部分です。金額の確定や外部送信などは、音声会話だけで完結させず、明示的な確認画面・確認フローを用意しましょう。
ブラウザ、サーバー、電話でのつなぎ方
| 方法 | 向く場面 | 注意点 |
|---|---|---|
| WebRTC | ブラウザのマイク・スピーカーを使う会話アプリ | ブラウザではHTTPS(またはlocalhost)が必要。APIキーはサーバー側で扱います。 |
| WebSocket | サーバー側で音声を扱う構成 | 接続と音声ストリーム、認証の設計が必要です。 |
| SIP | 電話回線とつなぐ音声Agent | 電話連携向けの運用・通話品質・本人確認を別途検討します。 |
利用者の端末から直接秘密鍵を扱うのではなく、公式Quickstartどおりサーバー側でSessionを準備する構成を基本にすると安全です。
料金は$0.05/分。導入前にバックエンド費用も見る
OpenAI公式Pricingでは、GPT-Live-1 Sessionは$0.05/分です。Sessionは1分単位への切り上げではなく、秒単位で課金されます。目安として音声Sessionだけなら10分で$0.50、30分で$1.50、60分で$3.00です。
ただし、これは音声Session分だけです。委譲先のモデル、Web searchなどのTool、保存、通信、外部サービスは別の費用になり得ます。料金を考えるときは「会話時間」と「1会話あたりのバックエンド作業量」を分けて見積もりましょう。
試しやすい用途
- 画面を見ずに使う音声ナビ
- 学習の口頭練習や読み上げ
- 家計・タスクの音声入力
- 作業中の短い質問と進捗確認
慎重に設計したい用途
- 送金・注文など取り消しにくい処理
- 個人情報を扱う外部連携
- 誤認識が重大な影響を持つ操作
- 長時間の常時接続
まとめ
GPT-Live-1 APIは、音声会話を続けながら、必要な仕事をバックエンドのモデルやAgentへ渡せる仕組みです。full-duplexの会話、WebRTC・WebSocket・SIP、transcript、委譲を組み合わせることで、単純な読み上げより一歩進んだ音声体験を設計できます。
一方で、自然な会話はモデルだけで完成しません。割り込み時に何を止めるか、文字起こしをどう確定するか、確認が必要な操作をどう守るかまで設計して、まず小さな用途から検証するのが現実的です。